
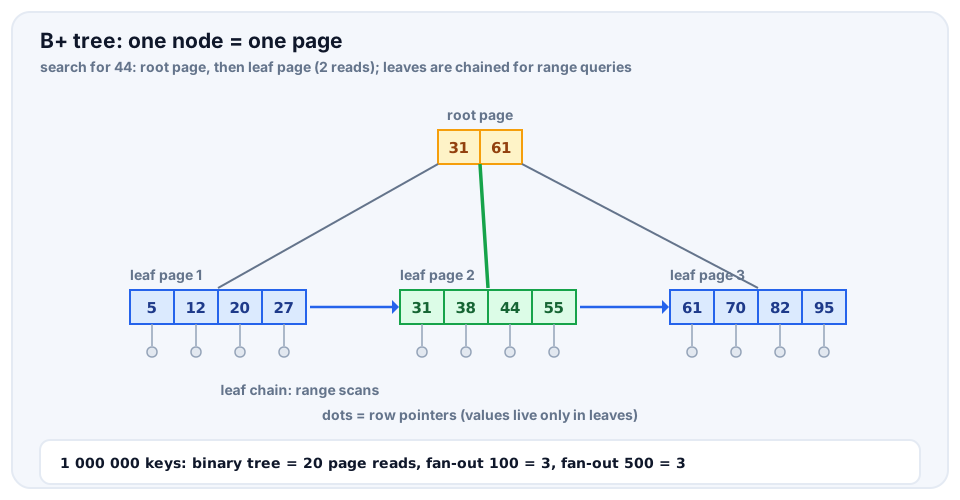
Двоичное дерево поиска хорошо в памяти, но когда данные лежат на диске, каждый шаг вниз — это отдельное чтение одной страницы (обычно 8 или 16 КБ), а чтение страницы в тысячи раз медленнее обращения к памяти. Для миллиарда ключей сбалансированное двоичное дерево имеет около 30 уровней, то есть 30 чтений с диска. B-дерево кладёт много ключей в один узел, так что узел занимает ровно одну страницу. Дерево получается широким и низким: на миллиард ключей хватает нескольких уровней.
Зачем широкие деревья
Каждый уровень стоит одного чтения страницы. Если узел ветвится на fanout путей, то на n ключей нужно около log_fanout(n) уровней:
def levels(n, fanout):
    """How many pages must be read to find one of n keys."""
    h, capacity = 0, 1
    while capacity < n:
        capacity *= fanout
        h += 1
    return h

for n in (1_000_000, 1_000_000_000):
    print(n, "binary:", levels(n, 2), "fan-out 100:", levels(n, 100),
"fan-out 500:", levels(n, 500))1000000 binary: 20 fan-out 100: 3 fan-out 500: 3
1000000000 binary: 30 fan-out 100: 5 fan-out 500: 4В странице 8 КБ помещается около 500 записей по 16 байт (ключ и указатель), так что реальный fanout — несколько сотен.
Структура
B-дерево с минимальной степенью t (под «порядком» часто понимают максимум детей 2t):
- в каждом узле
t-1 … 2t-1ключей (в корне1 … 2t-1) и, если узел не лист, на одного ребёнка больше, чем ключей; - ключи узла отсортированы, а ключи ребёнка
iлежат междуkeys[i-1]иkeys[i]: это обобщение BST; - все листья на одном уровне;
- высота
h ≤ log_t((n+1)/2).
Поиск идёт от корня вниз: внутри узла позицию находит двоичный поиск (bisect_left), затем переходим к ребёнку с этим индексом. Цена: O(log n) чтений страниц и O(log t) сравнений на страницу.
